Quando vários alarmes disparam ao mesmo tempo, o problema não é apenas técnico, é operacional. Um laboratório precisa de um método simples para separar o que ameaça a segurança, o que impacta a qualidade e o que pode aguardar alguns minutos sem ampliar o risco. Um checklist bem definido reduz ruído, organiza a resposta da equipe e evita que um alerta crítico se perca no meio de notificações secundárias.
Este guia é útil para gestores, responsáveis técnicos, qualidade, manutenção e operações. Ao longo do texto, você verá como priorizar eventos, distribuir responsabilidades e usar monitoramento com inteligência para transformar uma fila de alertas em ação coordenada.
Destaques que fazem diferença na rotina
- Nem todo alerta deve receber a mesma urgência, a criticidade precisa considerar impacto em amostras, pacientes, insumos e continuidade operacional.
- Um fluxo curto de triagem reduz atraso na resposta e evita fadiga de alarmes.
- Checklist funciona melhor quando define responsável, tempo máximo de ação, evidência esperada e critério de escalonamento.
- Eventos recorrentes precisam virar análise de causa, não apenas fechamento administrativo.
- Plataformas com monitoramento contínuo e IA, como a Drome, ajudam a detectar padrões antes da falha visível.
O primeiro passo é classificar alertas por risco real
A forma mais segura de lidar com múltiplas ocorrências é classificar por impacto potencial, não pela ordem em que elas aparecem. Em laboratório, um desvio pequeno em um equipamento que armazena insumos críticos pode ser mais grave do que várias notificações informativas em paralelo.
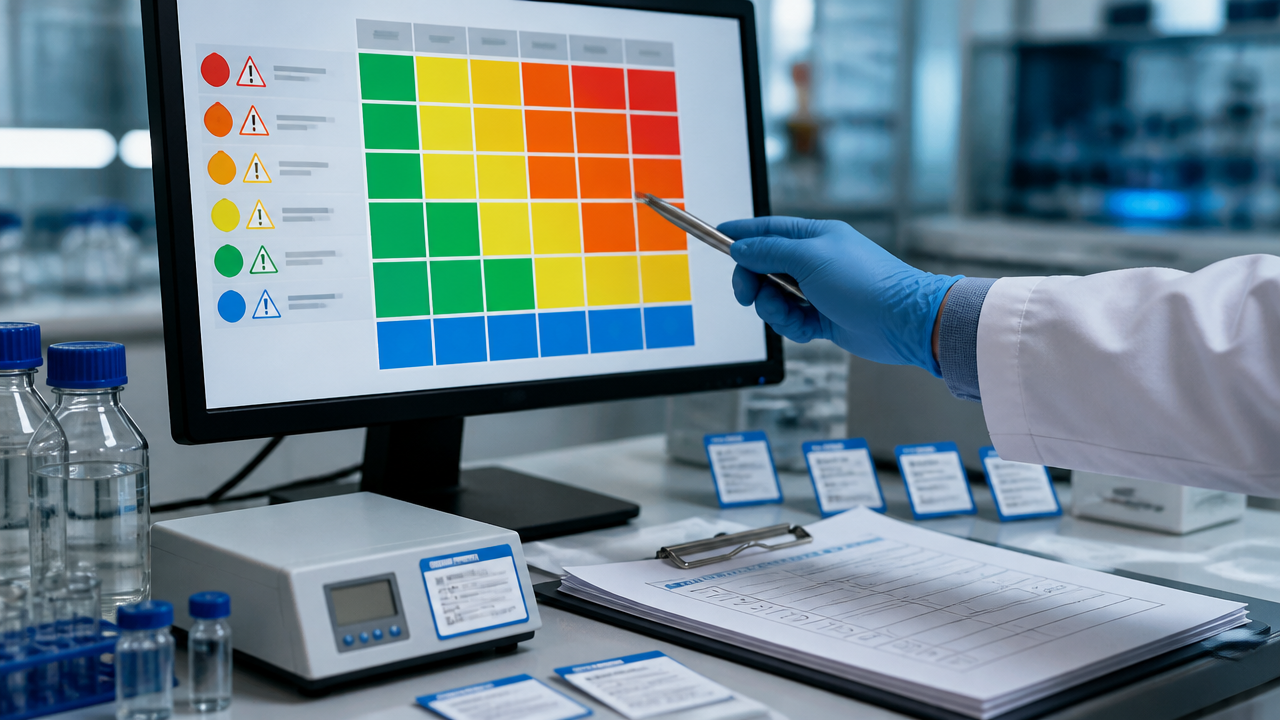
Uma classificação prática deve considerar quatro perguntas: o evento afeta material sensível, interrompe exame, compromete conformidade ou cria risco assistencial? Se a resposta for sim para qualquer uma delas, o alerta sobe de prioridade. Isso evita que a equipe trate volume como sinônimo de gravidade.
| Nível | Exemplo | Resposta esperada |
|---|---|---|
| Crítico | Falha em refrigeração de insumos, perda de energia, equipamento essencial fora de faixa | Ação imediata, escalonamento e registro completo |
| Alto | Tendência de temperatura instável, atraso de calibração, oscilação recorrente | Verificação rápida e contenção |
| Médio | Alerta de comunicação intermitente, atraso operacional sem impacto direto | Tratativa programada no turno |
| Baixo | Notificação informativa sem risco atual | Acompanhamento e revisão posterior |
Checklist prático para triagem de múltiplos alertas
Se a equipe precisar decidir em menos de um minuto, o checklist precisa ser direto. O objetivo aqui não é produzir um manual longo, mas padronizar a primeira resposta para proteger a operação.
- Confirmar se o alerta é real, duplicado ou consequência de outro evento principal.
- Identificar o ativo afetado, por exemplo freezer, incubadora, sala limpa, nobreak ou equipamento analítico.
- Verificar impacto imediato em amostras, medicamentos, reagentes ou exames em andamento.
- Definir criticidade com base em limite, duração, tendência e contexto operacional.
- Atribuir um responsável nominal pela ação inicial.
- Executar contenção, como transferência de carga, isolamento, ajuste operacional ou acionamento técnico.
- Registrar horário, decisão tomada e evidência de normalização.
- Escalonar se o tempo de resposta ultrapassar o limite da rotina.
Esse fluxo simples já elimina dois erros comuns: deixar alertas sem dono e encerrar ocorrências sem verificar efeito real sobre o processo. Em ambientes críticos, fechar um aviso no sistema não significa que o risco foi removido.
Quem responde ao quê, a equipe precisa saber antes do incidente
O melhor momento para definir papéis é antes de uma sobrecarga de eventos. Quando há dúvida sobre quem avalia, quem autoriza e quem executa, o tempo se perde justamente na fase mais sensível da ocorrência.
Uma boa prática é separar funções em três frentes: operação, suporte técnico e decisão de contingência. A operação faz a validação inicial e a contenção básica. O suporte técnico investiga causa provável e restabelece condição estável. A liderança decide sobre descarte, interrupção de fluxo, abertura de desvio e comunicação com qualidade.
Também vale criar tempos máximos por nível de risco. Um alerta crítico não pode esperar a troca de turno para ser revisado. Já um aviso médio pode entrar em fila com acompanhamento visível. Essa distinção protege a equipe do excesso de urgência artificial, que é uma das raízes da fadiga de alarmes.
Como reduzir fadiga de alarmes sem perder sensibilidade
Excesso de notificação enfraquece a atenção da equipe. Se tudo chega como urgente, nada parece realmente urgente. Por isso, reduzir fadiga de alarmes não significa silenciar eventos importantes, mas eliminar redundância e melhorar contexto.
Comece revisando três pontos: limites mal configurados, alertas duplicados e notificações sem ação possível. Um aviso deve existir para provocar uma resposta clara. Se o sistema gera eventos que não mudam nenhuma conduta, ele adiciona ruído e desgasta a operação.
Outro ajuste importante é combinar limite com persistência e tendência. Em vez de disparar por qualquer oscilação curta, o laboratório pode considerar duração mínima, repetição e velocidade de variação. Isso torna a triagem mais inteligente e reduz falso positivo, especialmente em refrigeração, ambiente controlado e equipamentos sujeitos a ciclos normais de uso.
O que muda quando o laboratório usa monitoramento com IA
A principal mudança é sair do modelo reativo. Em vez de apenas avisar quando o limite já foi rompido, a análise de comportamento ajuda a detectar sinais que antecedem a falha. Isso amplia a janela de resposta e reduz perda operacional.
Na prática, soluções como a plataforma da Drome combinam monitoramento contínuo, telemetria e inteligência artificial para observar padrões, identificar anomalias e apoiar a decisão da equipe. Isso é especialmente útil quando o laboratório administra muitos ativos ao mesmo tempo e precisa distinguir um evento pontual de uma tendência perigosa.
Esse tipo de abordagem também melhora a revisão pós incidente. Quando os dados ficam organizados por histórico, frequência e contexto, fica mais fácil descobrir quais equipamentos geram ocorrências repetidas, quais turnos concentram desvios e quais limites precisam ser recalibrados. O alerta deixa de ser um ponto isolado e passa a compor uma visão operacional mais madura.
Como transformar o checklist em rotina de gestão
Checklist só funciona quando sai do papel e entra no turno. Para isso, ele deve estar incorporado ao fluxo de resposta, ao treinamento e à revisão de desempenho. O documento precisa ser curto, acessível e compatível com a realidade do laboratório.
Uma implementação eficaz costuma seguir cinco práticas:
- treinar a equipe com cenários reais e tempos de decisão curtos;
- revisar mensalmente alertas recorrentes e causas não resolvidas;
- alinhar critérios com qualidade, manutenção e operação;
- auditar registros para verificar se houve evidência de contenção e normalização;
- atualizar o checklist sempre que surgir novo risco, ativo ou processo crítico.
Se o laboratório já possui sensores, supervisão e histórico operacional, o próximo passo é integrar esses dados a uma lógica de priorização mais inteligente. Esse é o ponto em que tecnologia e governança deixam de competir entre si e passam a trabalhar juntas.
Perguntas frequentes
O que é gerenciamento de risco em laboratório?
Gerenciamento de risco em laboratório é o processo de identificar, classificar, responder e revisar eventos que podem comprometer amostras, insumos, equipamentos, resultados ou a segurança da operação. Na prática, isso inclui definir prioridades, responsáveis, tempos de resposta e critérios de escalonamento para cada tipo de alerta.
Quais são as 3 fases laboratoriais?
As três fases laboratoriais são pré analítica, analítica e pós analítica. A gestão de alertas precisa cobrir as três, porque desvios de temperatura, falhas de equipamento, atraso no processamento e erro de registro podem surgir em momentos diferentes do fluxo e exigir respostas distintas.
Quais são os principais erros pré analíticos?
Os principais erros pré analíticos incluem identificação incorreta, acondicionamento inadequado, atraso no transporte, temperatura fora da faixa e coleta em condições impróprias. Um bom processo de alertas ajuda a detectar essas falhas cedo, antes que o problema afete a validade da amostra ou o prazo do exame.
Qual é a RDC atualizada para laboratórios?
A melhor RDC depende do tipo de laboratório e da atividade realizada, por isso a resposta correta é sempre verificar a norma vigente aplicável ao seu escopo. Para a rotina interna, o mais importante é traduzir exigências regulatórias em critérios operacionais claros, com registro, rastreabilidade e responsáveis definidos.
Leia também
5 dicas para fortalecer a rastreabilidade em laboratórios
Aprenda cinco ações práticas para melhorar a rastreabilidade digital em laboratórios, reduzir desvios e ganhar mais controle operacional.
Alarmes em laboratórios, como reduzir o ruído
Saiba como reduzir alertas desnecessários em laboratórios automatizados com priorização, calibração, manutenção preditiva e inteligência art…
Como escolher sensores de pressão para laboratórios
Veja um checklist prático para selecionar sensores de pressão diferencial em laboratórios, com foco em precisão, instalação, validação e ris…